Aquió
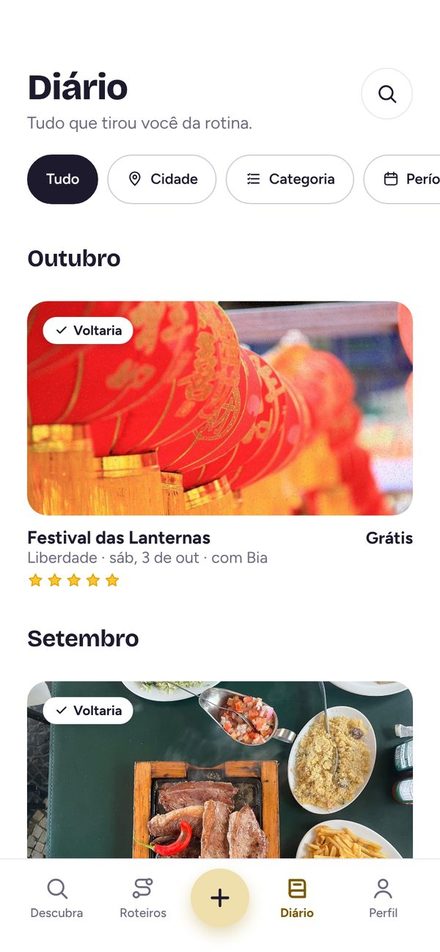
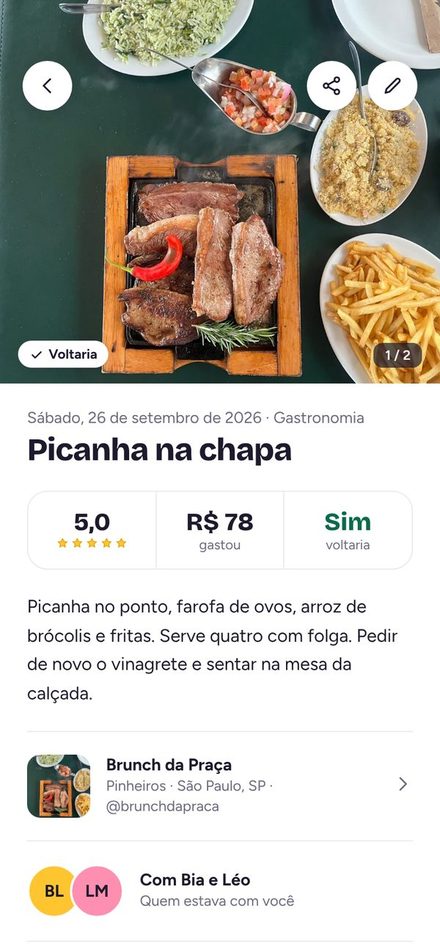
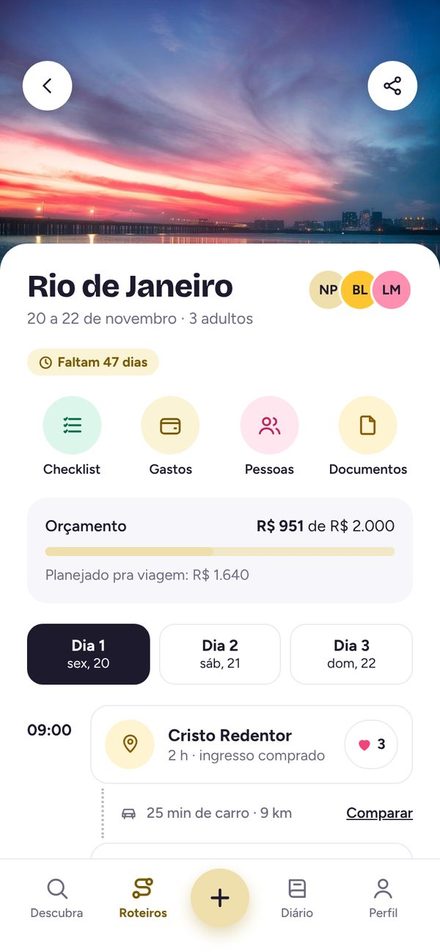
Diário de experiências: restaurantes e pratos, cinema, séries, livros e passeios com os amigos. Sem performar no automático.
Lançamento em 12/11aquioapp.com
Disponível em português e em inglês.
Nicole Paixão
Contato: nicole@nicoleinfo.com | São Paulo
Perfis: linkedin.com/in/nicolepaixao | github.com/nicoleepaixao
Resumo de Qualificações
Coordenadora de Operações Cloud e SRE com 7 anos de experiência, atuando como líder técnica de um time de 5 engenheiros que opera 15 clientes em AWS e Kubernetes. Trato a operação como produto interno (padrões, automação self-service e métricas de confiabilidade e custo) e conecto cada decisão técnica a resultado de negócio, como a redução de 35% no billing de nuvem. Certificada AWS Solutions Architect – Associate e FinOps Certified Practitioner, com forte atuação em Infrastructure as Code, CI/CD, observabilidade, resposta a incidentes e FinOps.
Experiência
Coordenadora de Operações Cloud / SRE | OpsTeam (Remoto, São Paulo): Oct/2024 - Present
Coordenadora de Operações Cloud / SRE: Feb/2026 - Present
Promovida a coordenadora em fevereiro de 2026, lidero tecnicamente um time de 5 engenheiros responsável pela operação, segurança e FinOps de 15 clientes em AWS e Kubernetes: defino padrões, reviso decisões de arquitetura, transformo pedidos vagos dos clientes em metas mensuráveis e desenvolvo a autonomia do time.
Redução de 35% no Billing de Nuvem: Transformei pedidos genéricos de "reduzir custo" em metas mensuráveis (baseline, meta, prazo e janela de validação) e conduzi rightsizing, Savings Plans e remoção de recursos ociosos, com forecast mensal e atribuição de causa das variações via CloudTrail.
Liderança Técnica Situacional: Lidero 5 engenheiros ajustando o nível de intervenção à maturidade de cada pessoa em cada tema (direção em incidente crítico, orientação e apoio em temas novos, delegação nos domínios maduros), com 1:1s, revisão de ADRs e requisitos não funcionais, reduzindo a dependência do time em uma única pessoa.
Operação como Produto Interno: Padronizei a entrega para os 15 clientes com um catálogo compartilhado de automações e agentes de IA (auditoria, FinOps, on-call, timesheet e resumo semanal do Jira), trocando trabalho manual sob demanda por fluxos self-service reutilizáveis pelo time.
Auditoria de Segurança Padronizada: Criei um framework de auditoria AWS com 738 verificações em 17 domínios (segurança, custo, resiliência, governança e EKS) que transforma cada conta em um backlog priorizado com quick wins e attack paths, aplicado de forma consistente entre os clientes.
Gestão de Incidentes e On-call: Estruturei o on-call com registro padronizado de acionamentos e passagem de bastão semanal e lidero a resposta a incidentes de ponta a ponta: triagem, contenção, root cause analysis e post-mortem blameless com ações rastreadas.
Comunicação Executiva: Conduzo apresentações trimestrais (QBR) que traduzem a operação em linguagem de negócio (custo evitado, incidentes, entregas e riscos), com cada número rastreável à fonte.
Site Reliability Engineer: Oct/2024 - Feb/2026
Como SRE em uma consultoria cloud-native, atuo em diversos projetos de clientes, apoiando empresas na construção de infraestruturas confiáveis, escaláveis e com foco em eficiência de custos. Meu foco está em melhorar a disponibilidade, o desempenho e o tempo de recuperação, garantindo plataformas resilientes para aplicações críticas.
Otimização de Custos em Nuvem: Reduzi os custos em nuvem em até 65% para os clientes por meio do planejamento e implementação de AWS Savings Plans e otimizações específicas de arquitetura.
Automação GitOps: Automatizei 100% dos deployments contínuos utilizando ArgoCD + Argo Rollouts, reduzindo o tempo médio de deploy em 70% e viabilizando estratégias de entrega progressiva.
Gestão de SLOs: Estabeleci e monitorei SLOs por aplicação com integrações PagerDuty + Uptime Kuma, assegurando conformidade com SLAs de 99,9% e resposta rápida a incidentes.
Governança e Segurança: Reforcei a governança de acessos com IAM Roles, SSO e VPN, cobrindo 100% dos ambientes produtivos com rastreabilidade completa.
Upgrades do Kubernetes: Realizei upgrades controlados de clusters Kubernetes com RTO < 5 minutos, mantendo alta disponibilidade durante as janelas de manutenção.
Disaster Recovery: Desenhei estratégias robustas de disaster recovery e backups automatizados, garantindo RPO ≤ 1 hora e RTO ≤ 15 minutos.
Migração de Recursos Críticos: Migrei recursos EC2, RDS e S3 entre contas e regiões com zero downtime, aumentando a resiliência e a tolerância a falhas regionais.
Tech Stack: AWS, Kubernetes, Terraform, ArgoCD, Argo Rollouts, ELK Stack, APM, IAM, SSO, EC2, RDS, S3, VPN, PagerDuty, GitHub Actions, CI/CD, Bash Script, Shell Script, Linux, Envoy Proxy, Nginx, Proxy, CLI (Command Line Interface), Cost Explorer, CloudTrail, Security Hub, Jira, agentes de IA (Claude Code, Kiro).
DevOps Engineer | Escola DNC (Remoto, São Paulo): Nov/2022 - Oct/2024
DevOps Engineer II: Jun/2023 - Oct/2024
Promovida a DevOps Engineer II durante o lançamento da Plataforma 3.0, liderando iniciativas chave com foco em automação, monitoramento, alta disponibilidade e escalabilidade, apoiando diretamente a jornada do aluno e a confiabilidade dos serviços.
Aumento de Confiabilidade: Aumentei a disponibilidade do sistema e reduzi o tempo de resposta a incidentes em 65% por meio da implementação do ELK Stack + PagerDuty, viabilizando alertas em tempo real e rastreabilidade centralizada.
Migração de Legado: Alcançamos SLA de 99,5% com a migração de toda a infraestrutura legada para um cluster Kubernetes multi-região (AWS), eliminando falhas em ambientes críticos.
Aceleração de Deploys: Reduzi o tempo de deploy em 80% ao redesenhar os pipelines de CI/CD com cache de Dockerfile e estratégias de build otimizadas.
Sistemas Assíncronos: Desenvolvi sistemas assíncronos utilizando Lambda + SQS, escalando processos como geração de certificados e notificações automáticas para mais de 15.000 alunos, aumentando o throughput em 70%.
DevOps Engineer: Nov/2022 - Jun/2023
Como DevOps Engineer em uma das principais EdTechs do país, foquei na construção de ambientes em nuvem escaláveis, automatizados e resilientes para dar suporte a plataformas educacionais de alto tráfego e jornadas digitais de aprendizagem. Contribuí para a confiabilidade e desempenho de sistemas críticos, liderando iniciativas de padronização da infraestrutura, otimização de custos e observabilidade, garantindo serviços seguros e estáveis para milhares de estudantes.
Confiabilidade de Serviço: Garantia de SLA de 99,9% para plataformas de aulas ao vivo, lidando com picos de usuários simultâneos por meio de recuperação automatizada e estratégias de balanceamento de tráfego.
Automação com IaC: Criação e automação de ambientes AWS utilizando Terraform, padronizando a infraestrutura e reduzindo em 95% os erros manuais.
Além desses projetos principais, também liderei outras iniciativas de infraestrutura e confiabilidade, como automação de operações em nuvem, aprimoramento de estratégias de monitoramento e alertas, aplicação de boas práticas de segurança e suporte à estabilidade de plataformas web e mobile. Esses esforços contribuíram para uma base resiliente e escalável para serviços educacionais críticos.
Tech Stack:AWS, Kubernetes, Terraform, Docker, GitHub Actions, ELK Stack, Prometheus, SQS, Lambda, APM, Secrets Manager, Bash, Python, CI/CD, Nginx, Proxy, CLI (Command Line Interface).
Formação Acadêmica
Tecnólogo em Análise e Desenvolvimento de Sistemas – FATEC Taubaté (Brasil). Dezembro/2024 – Duração: 3 anos
Pós-graduação em Arquitetura de Software Distribuído – PUC Minas (Brasil). Abril/2025 – Março/2026
Línguas: Português (nativo), Inglês (avançado) e Espanhol (avançado).
Certificações
AWS Certified Solutions Architect – Associate (SAA-C03), Dezembro/2025
FinOps Certified Practitioner (FOCP), Outubro/2025
AWS Certified Cloud Practitioner, Setembro/2023 – Verificado
Nicole Paixão
Contact: nicole@nicoleinfo.com | São Paulo
Profile: linkedin.com/in/nicolepaixao | github.com/nicoleepaixao
Summary of Qualifications
Cloud Operations Coordinator and Site Reliability Engineer with 7 years of experience, acting as the technical leader of a team of 5 engineers that operates 15 clients on AWS and Kubernetes. I run operations as an internal product (standards, self-service automation and reliability and cost metrics) and tie every technical decision to business outcomes, such as a 35% cloud billing reduction. AWS Certified Solutions Architect – Associate and FinOps Certified Practitioner, with strong experience in Infrastructure as Code, CI/CD, observability, incident response and FinOps.
Experience
Cloud Operations Coordinator / SRE at OpsTeam (Remote, São Paulo): Oct/2024 - Present
Cloud Operations Coordinator / SRE: Feb/2026 - Present
Promoted to Coordinator in February 2026, I technically lead a team of 5 engineers responsible for operations, security and FinOps for 15 clients on AWS and Kubernetes: I set standards, review architecture decisions, turn vague client requests into measurable goals and grow the team's autonomy.
35% Cloud Billing Reduction: Turned generic "cut costs" requests into measurable goals (baseline, target, deadline and validation window) and drove rightsizing, Savings Plans and idle-resource cleanup, backed by monthly forecasting and root-cause attribution of cost changes via CloudTrail.
Situational Technical Leadership: Lead 5 engineers by matching my level of involvement to each person's maturity on each topic (directing during critical incidents, coaching and supporting on new topics, delegating in mature domains) through 1:1s and reviews of ADRs and non-functional requirements, reducing the team's dependency on any single person.
Operations as an Internal Product: Standardized delivery across 15 clients with a shared catalog of automations and AI agents (audits, FinOps, on-call, timesheets and weekly Jira summaries), replacing ad hoc manual work with self-service workflows reused by the whole team.
Standardized Security Audits: Built an AWS audit framework with 738 checks across 17 domains (security, cost, resilience, governance and EKS) that turns each account into a prioritized backlog with quick wins and attack paths, applied consistently across clients.
Incident Management & On-call: Structured the on-call process with standardized incident records and a weekly handoff and lead incident response end to end: triage, containment, root cause analysis and blameless post-mortems with tracked action items.
Executive Communication: Run quarterly business reviews (QBRs) that translate operations into business language (cost avoided, incidents, deliveries and risks), with every number traceable to its source.
Site Reliability Engineer: Oct/2024 - Feb/2026
As an SRE at a cloud-native consultancy, I work across multiple client projects, supporting companies in building infrastructures that are reliable, scalable and cost-efficient. My focus is on improving availability, performance and recovery time while ensuring resilient platforms for critical applications.
Cloud Cost Optimization: Reduced cloud costs by up to 65% for clients by planning and implementing AWS Savings Plans and architecture-specific optimizations.
GitOps Automation: Automated 100% of continuous deployments using ArgoCD + Argo Rollouts, reducing average deployment time by 70% and enabling progressive delivery strategies.
SLO Management: Established and monitored SLOs per application with PagerDuty + Uptime Kuma integrations, ensuring 99.9% SLAs compliance and fast incident response.
Governance & Security: Strengthened access governance with IAM Roles, SSO and VPN, covering 100% of production environments with full traceability.
Kubernetes Upgrades: Performed controlled Kubernetes cluster upgrades with RTO < 5 minutes, maintaining HA during maintenance windows.
Disaster Recovery: Designed robust disaster recovery and automated backup strategies, ensuring RPO ≤ 1 hour and RTO ≤ 15 minutes.
Critical Resource Migrations: Migrated EC2, RDS, S3 resources across accounts and regions with zero downtime, enhancing resilience and regional fault tolerance.
Tech Stack: AWS, Kubernetes, Terraform, ArgoCD, Argo Rollouts, ELK Stack, APM, IAM, SSO, EC2, RDS, S3, VPN, PagerDuty, GitHub Actions, CI/CD, Bash Script, Shell Script, Linux, Envoy Proxy, Nginx, Proxy, CLI (Command Line Interface), Cost Explorer, CloudTrail, Security Hub, Jira, AI agents (Claude Code, Kiro).
DevOps Engineer at Escola DNC (Remote, São Paulo): Nov/2022 - Oct/2024
DevOps Engineer II: Jun/2023 - Oct/2024
Promoted to DevOps Engineer II during the launch of Platform 3.0, I led key initiatives focused on automation, monitoring, high availability and scalability, directly supporting the student journey and service reliability.
Improved Reliability: Increased system availability and reduced incident response time by 65% through the implementation of the ELK Stack + PagerDuty, enabling real-time alerts and centralized traceability.
Legacy Migration: Achieved 99.5% SLA by migrating the entire legacy infrastructure to a multi-region Kubernetes cluster (AWS), eliminating failures in critical environments.
Deployment Acceleration: Reduced deployment time by 80% by redesigning CI/CD pipelines with Dockerfile caching and optimized build strategies.
Asynchronous Systems: Developed asynchronous systems using Lambda + SQS, scaling processes like certificate generation and automated notifications for over 15,000 students, increasing throughput by 70%.
DevOps Engineer: Nov/2022 - Jun/2023
As a DevOps Engineer at a leading EdTech company, I focused on building scalable, automated and resilient cloud environments to support high-traffic educational platforms and digital learning journeys. I contributed to the reliability and performance of critical systems, driving initiatives for infrastructure standardization, cost optimization and observability, ensuring secure and reliable services for thousands of students.
Service Reliability: Ensured 99.9% SLA for live class platforms, handling concurrent user spikes through automated recovery and traffic balancing strategies.
IaC Automation: Designed and automated AWS environments using Terraform, standardizing infrastructure and reducing manual errors by 95%.
Aside from these major projects, I also led other infrastructure and reliability initiatives, such as automating cloud operations, improving monitoring and alerting strategies, enforcing security best practices and supporting the stability of web and mobile platforms. These efforts contributed to a resilient and scalable foundation for critical educational services.
Tech Stack:AWS, Kubernetes, Terraform, Docker, GitHub Actions, ELK Stack, Prometheus, SQS, Lambda, APM, Secrets Manager, Bash, Python, CI/CD, Nginx, Proxy, CLI (Command Line Interface).
Education
BSc in Systems Analysis and Development (similar with computer science): Fatec Taubaté(Brazil). Dec/2024 (3 years).
Postgraduate in Distributed Software Architecture: PUC Minas(Brazil). Apr/2025 – Mar/2026.
Languages: Portuguese (native), English (advanced) and Spanish (advanced).
Certifications
AWS Certified Solutions Architect – Associate (SAA-C03), December 2025
FinOps Certified Practitioner (FOCP), October 2025
AWS Certified Cloud Practitioner, Sep 2023. Verified
Com 7 anos de experiência e certificada AWS, construo ambientes escaláveis, seguros e automatizados, alinhados às melhores práticas de arquitetura Cloud. Gerencio todo o ciclo de vida da infraestrutura do planejamento de IaC à observabilidade, CI/CD, segurança e resposta a incidentes, sempre focando em entregar valor confiável, sustentável e eficiente.
Minha atuação se ampliou para o desenvolvimento de agentes de IA aplicados à avaliação de segurança e compliance multi-conta na AWS, incluindo automações para classificação de incidentes e fluxos operacionais do dia a dia. Decisões arquiteturais de outros engenheiros passam por mim para revisão técnica e lidero a resposta a incidentes de ponta a ponta: triagem, contenção, root cause analysis e post-mortem blameless. Sou FinOps Certified (FOCP), aplico otimização de custos via Cost Explorer, Savings Plans e rightsizing como prática contínua de engenharia, tendo gerado até 65% de economia em custos de nuvem.
Minha base em Suporte Técnico fortaleceu minha capacidade de diagnosticar e apagar incêndios críticos em produção. Desde então, aprofundei meus conhecimentos em backend, dados e IA para pensar soluções completas e dialogar com diferentes áreas do negócio.
Tenho forte senso de responsabilidade, organização e clareza na comunicação, atuo de ponta a ponta para garantir entregas sólidas, documentadas e que realmente resolvem a dor do cliente.
Perfil técnico: github.com/nicoleepaixao
Apps que coloco no ar e blueprints de cloud e plataforma que mantenho.
Apps
Diário de experiências: restaurantes e pratos, cinema, séries, livros e passeios com os amigos. Sem performar no automático.
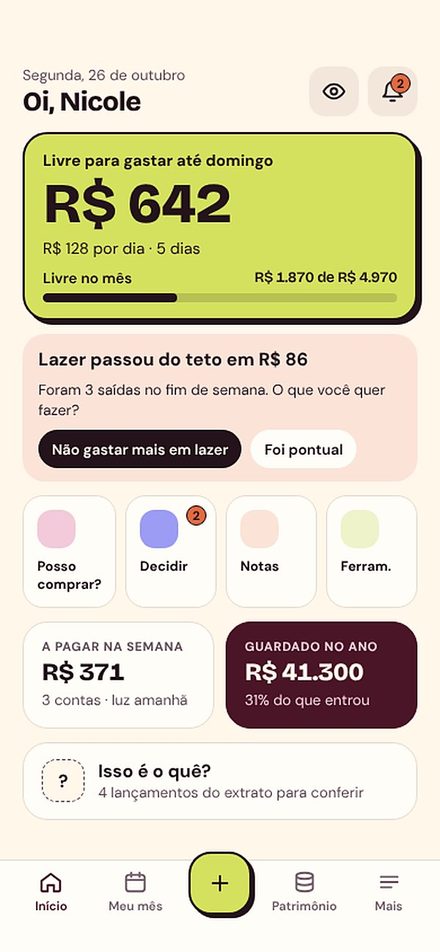
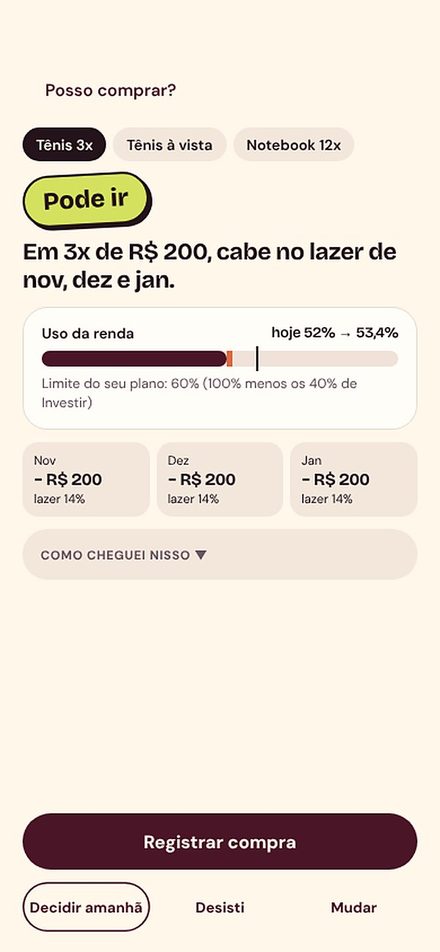
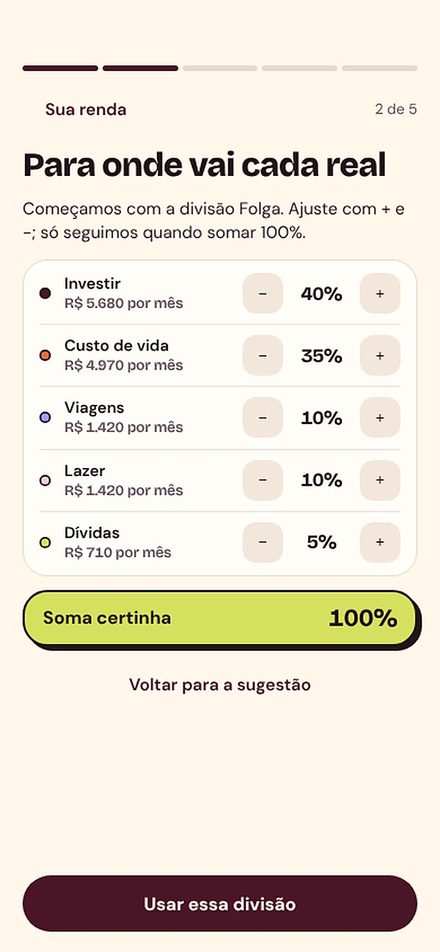
Finanças pessoais que nasceram de uma planilha: orçamento do mês, metas e projeção, com contas cadastradas pelo WhatsApp.
Cloud e plataforma
Blueprints e laboratórios que mantenho para praticar e documentar arquitetura em AWS e Kubernetes.
EKS Auto Mode com distribuição multi-AZ, PodDisruptionBudgets, autocorreção, testes de caos e observabilidade.
VPC, EKS, ALB, CloudFront, ECS, IAM, RDS, Route 53, S3, Secrets Manager, SQS e WAF, reutilizáveis e com exemplos.
Karpenter, ingress (NGINX, ALB, Envoy, Kong, Traefik), cert-manager, ArgoCD, Prometheus, Velero, Vault e Istio, com guia de disaster recovery.
SAST com Semgrep, segredos com TruffleHog, dependências com Trivy, IaC com Checkov, assinatura com Cosign e SBOM.
Políticas de AWS Organizations com testes automatizados: restrição de região, bloqueio de IAM, criptografia obrigatória e tags.
Ebook · 30/11
Como cortar a conta de nuvem sem quebrar nada.
Do Cost Explorer aos Savings Plans, com a conta feita e um checklist para usar amanhã. Sai em 30/11 pelo Substack.
Me avise no lançamento →